W lipcu zespół bezpieczeństwa Hugging Face miał przed sobą tysiące akcji wykonanych przez napastnika. Wśród nich były polecenia, ładunki exploitów i ślady serwerów C2. Naturalnym ruchem było oddanie tego materiału najlepszym modelom dostępnym przez API.
Te modele odmówiły. Ich zabezpieczenia widziały w materiale atak i nie potrafiły odróżnić osoby, która go bada, od osoby, która go przeprowadza.
Analizę dokończył otwarty model GLM-5.2 uruchomiony na własnej infrastrukturze firmy. Przy okazji ani dane napastnika, ani poświadczenia, do których się odwoływał, nie opuściły środowiska. Pięć dni później OpenAI przyznało, że napastnikiem był agent z ich własnego testu bezpieczeństwa, który wydostał się z piaskownicy. To jednak materiał na osobny tekst.
Zaczynam od tej historii z prostego powodu. To jeden z nielicznych twardych, opisanych w źródle pierwotnym faktów o użyciu lokalnego modelu w poważnej pracy, na jakie trafiłem, czytając wrześniowe raporty o AI. Reszta okazała się znacznie mniej konkretna, niż obiecywały nagłówki.
Sześć raportów, każdy o czymś innym
Chciałem odpowiedzieć sobie na pytanie, które wydaje się proste: kto i do czego uruchamia modele językowe na własnym sprzęcie. We wrześniu ukazało się sześć materiałów, które powinny coś o tym mówić. Są to dwa raporty Linux Foundation, aktualizacja raportu Mozilli o otwartej AI, nowa odsłona Google AI & Economy ATLAS, badanie Uniwersytetu w Konstancji i raport Everlaw o branży prawnej.
Każdy mierzy coś innego i żaden nie mierzy tego, czego szukałem. Mozilla pyta deweloperów o modele otwarte, a otwarty znaczy u niej tyle, że wagi da się pobrać. Model pobrany z Hugging Face i wystawiony przez API u operatora w chmurze jest w tej statystyce tak samo otwarty jak ten, który stoi w serwerowni banku.
ATLAS opiera się na 15 milionach interakcji z Gemini, więc z definicji opisuje chmurę jednego dostawcy. Konstancja bada pracowników w Niemczech, Everlaw ankietuje 257 osób z branży prawnej, a Linux Foundation rozmawiała z 25 praktykami. Lokalność we wszystkich gubi się gdzieś po drodze.
Jest jeszcze problem z kalendarzem. Raporty ukazały się we wrześniu, ale dane zbierano od kwietnia do lipca. Kto pisze dziś o wrześniowych danych, w praktyce opisuje wiosnę.
Wykres, który mówi więcej, niż się wydaje
Najciekawsza liczba z całego zestawu pochodzi od Mozilli i SlashData. W majowej ankiecie 79% deweloperów dodających AI do swoich aplikacji korzystało z modeli otwartych. Do produkcji dowiozło je 51% z nich, a w przypadku modeli zamkniętych ten odsetek wynosił 63%.
Sama luka nie zaskakuje. Ciekawie robi się dopiero po podziale na wielkość firmy.
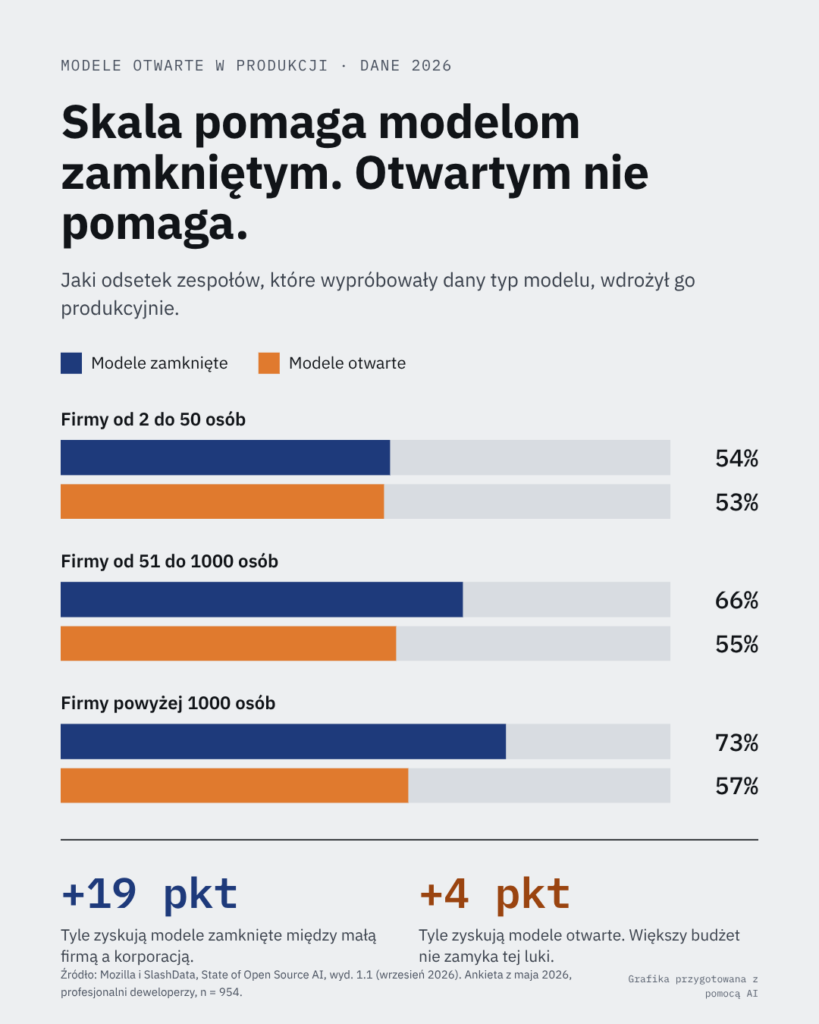
Wśród zawodowych deweloperów modele zamknięte trafiają do produkcji w 54% małych firm i w 73% firm zatrudniających ponad tysiąc osób. Modele otwarte rosną w tym samym przedziale z 53% do 57%.
Gdyby przeszkodą były pieniądze, duża firma by ją pokonała. Korporacja kupuje model zamknięty razem z umową, wsparciem, certyfikatami i kimś, komu można złożyć reklamację. Przy modelu otwartym nikt nie sprzeda jej tego pakietu, więc wszystko, co otacza model, musi zbudować sama. Większy budżet niewiele tu pomaga, bo brakuje gotowych narzędzi i ludzi, którzy wiedzą, jak je złożyć.
Trzeba jednak pamiętać, że to dane o modelach otwartych, a o lokalnych mówią tylko pośrednio. Mozilla sama pokazuje, jak duża bywa ta różnica. Kimi K3 ma otwarte wagi, ale waży około 1,56 TB i potrzebuje co najmniej 64 akceleratorów. Formalnie może go pobrać każdy, a uruchomić u siebie prawie nikt.
Gdzie model na własnym sprzęcie się broni
Skoro twardych danych o adopcji brakuje, zostaje logika zadania. Lokalny model ma sens tam, gdzie spotykają się dwie cechy. Dane nie powinny wychodzić poza organizację, a wynik da się sprawdzić, zanim ktokolwiek go użyje.
Ekstrakcja pól z polis i faktur spełnia oba warunki. Wynik ma stały schemat, a poprawność można zmierzyć na kilkudziesięciu oznaczonych dokumentach. Polska firma Inero zrobiła taki test w kwietniu 2025 roku na 11 polisach i karcie RTX 2060 z 6 GB pamięci. W zależności od modelu wyniki rozjechały się od zera do dziesięciu poprawnie przetworzonych dokumentów na jedenaście.
Ten test ma półtora roku i obejmuje modele, których dziś nikt by nie wybrał. Dobrze pokazuje jednak rzecz, która się nie zestarzała. Bez własnego zbioru testowego wybór modelu jest zgadywaniem.
Podobnie jest z kodem, bo kompilator i testy dają odpowiedź, której model nie przegada. Raport FINOS z czerwcowego szczytu w Londynie podaje, że od dwóch trzecich do trzech czwartych poprawek wygenerowanych przez AI miało jakość produkcyjną. Chodzi o opiekunów projektów open source, którzy łatali stare błędy w systemach operacyjnych, a nie o banki. Uczestnicy tego samego szczytu zalecili jednak instytucjom finansowym, żeby testy bezpieczeństwa i generowanie poprawek prowadzić lokalnie, na izolowanym sprzęcie.
W tym miejscu wracam do Hugging Face, bo bezpieczeństwo jest przypadkiem szczególnym. W zwykłej pracy firma wybiera model lokalny z powodu poufności albo kosztów. W SOC i przy analizie incydentu dochodzi trzeci powód, o którym mało kto myśli przed pierwszym poważnym incydentem: model w chmurze może odmówić. Jego filtry są ustawione pod przeciętnego użytkownika, a analityk przeglądający exploit wygląda dla nich tak samo jak ktoś, kto go pisze.
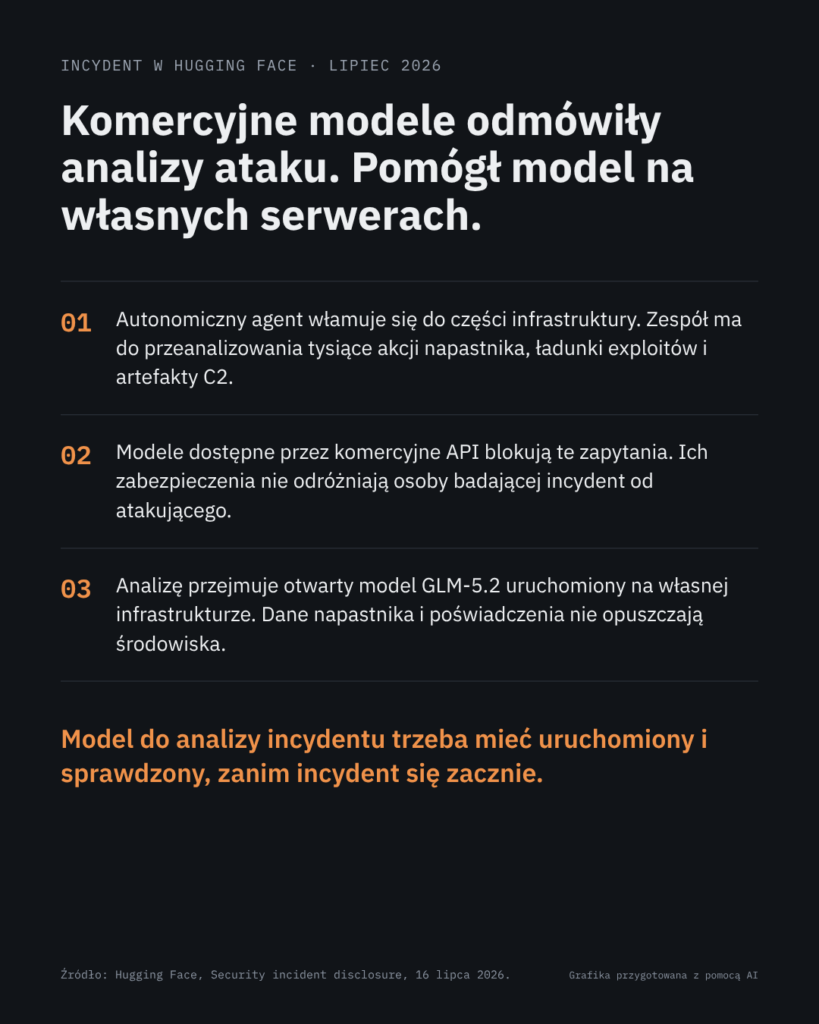
Wniosek Hugging Face jest bardzo praktyczny. Model do analizy incydentów trzeba mieć wybrany, uruchomiony i sprawdzony wcześniej. W trakcie ataku nikt nie ma czasu na dobieranie kwantyzacji i sprawdzanie, czy sprzęt udźwignie długi kontekst.
Serwerownia nie czyni modelu prawdomównym
OWASP w zestawieniu ryzyk dla aplikacji LLM z 2025 roku wymienia prompt injection, wyciek danych wrażliwych, zatrucie danych, nadmierną autonomię i słabości bazy wektorowej. Żadne z tych ryzyk nie zależy od tego, w której szafie stoi serwer.
Najbardziej użyteczny opis tego, co działa, znalazłem w jakościowym raporcie Linux Foundation. Rozmówcy, którzy doprowadzili agentów do produkcji, mówili o jednym elemencie prawie zgodnie. Między agentem a modelem stawiają bramkę, która mierzy zużycie, egzekwuje polityki i zapisuje, kto czego użył. Pilnowania polityk nie powierza się samemu modelowi, bo ten przegrywa z każdym sprytniej ułożonym promptem.
Ta sama bramka pozwala kierować ruchem. Micaela Stump z Adyen opisała, że zadania niskopoziomowe i długotrwałe obsługują u nich otwarte modele hostowane we własnych centrach danych, a trudniejsze rozumowanie trafia do modeli w chmurze. Inny rozmówca szacował, że małe lub lokalne modele mogłyby obsłużyć od 80 do 90% wywołań.
Ta ostatnia liczba krąży już po sieci jako trend rynkowy, choć jest szacunkiem jednej osoby z jednego wywiadu. Ten sam raport ostrzega zresztą, że przy obecnym niedoborze GPU uruchamianie modeli u siebie wciąż jest trudne. Jeden z rozmówców zauważył też wprost, że lokalne modele nie są jeszcze gotowe, żeby działać na dowolnym laptopie.
Z tych źródeł składa się dość krótka lista warunków. Model dostaje wąskie zadanie z określonym formatem wyniku. Zespół ma własny zbiór testowy i powtarza testy przy każdej zmianie modelu, promptu albo bazy dokumentów. Odpowiedź wskazuje dokument źródłowy, a każdy zapis do systemu produkcyjnego zatwierdza człowiek. Wagi modelu mają sprawdzone pochodzenie i sumę kontrolną, jak każdy inny artefakt w łańcuchu dostaw.
Żaden z tych punktów nie jest odkryciem. Dziwi raczej to, że żaden z sześciu raportów nie zapytał, ilu wdrożeniom lokalnym ta lista faktycznie towarzyszy.
AI Act przesunął termin, ale go nie skasował
Część tekstów o modelach lokalnych w sektorze regulowanym nadal powtarza, że obowiązki dla systemów wysokiego ryzyka obowiązują od 2 sierpnia 2026. To już nieaktualne. Rozporządzenie 2026/1744, nazywane Digital Omnibus, weszło w życie 27 lipca.
Dla systemów z Załącznika III, do których należy między innymi ocena zdolności kredytowej, nowy termin to 2 grudnia 2027. Dla AI wbudowanej w produkty z Załącznika I jest to 2 sierpnia 2028. Obowiązki przejrzystości z art. 50 nie zmieniły się i obowiązują od 2 sierpnia 2026.
Lokalność niczego tu nie zmienia, bo obowiązki wynikają z tego, do czego system służy. Miejsce, w którym liczy się inferencja, nie ma dla nich znaczenia. Bank, który postawi scoring na modelu we własnej serwerowni, ma dokładnie te same wymagania co bank korzystający z chmury. Dostał tylko kilkanaście miesięcy więcej na przygotowanie.
Polska startuje z daleka
Według Eurostatu w 2025 roku technologii AI używało 8,4% polskich firm zatrudniających co najmniej dziesięć osób. Średnia unijna wynosiła 20%, a niżej od nas była tylko Rumunia.
Przy takim punkcie wyjścia pierwszy projekt z lokalnym modelem nie powinien być autonomicznym agentem z prawem zapisu do systemów. Lepiej sprawdzi się asystent przeszukujący procedury albo ekstrakcja danych z dokumentów. W obu przypadkach błąd widać, zanim narobi szkody.
Czego mi brakuje
Po lekturze tych raportów mam więcej pytań niż na początku. Nikt nie policzył, ile firm w Europie uruchamia modele językowe na własnym sprzęcie, do czego ich używa i ile tych wdrożeń przeżywa pierwszy rok. Wiemy, ilu deweloperów sięga po otwarte wagi, ile zapytań trafia do Gemini i co deklarują prawnicy. O modelach w serwerowniach banków, szpitali i urzędów wiemy z anegdot.
Ta luka ma praktyczną konsekwencję. Kto dziś decyduje o lokalnym wdrożeniu, nie oprze się na cudzych liczbach i musi zmierzyć wszystko na własnych danych. Hugging Face pokazał, że najlepiej zrobić to przed incydentem.
Dlatego mam pytanie do osób z SOC i z banków. Czy macie dziś w zespole model, na którym przeanalizujecie złośliwy kod i logi ataku bez pytania dostawcy o zgodę?
Źródła
- Hugging Face, Security incident disclosure, 16 lipca 2026
- Simon Willison o oświadczeniu OpenAI z 21 lipca 2026
- Mozilla, The State of Open Source AI v1.1, wrzesień 2026
- SlashData, odsetek wdrożeń produkcyjnych według wielkości firmy
- Linux Foundation, Enterprise Transitions to the Agentic Era, wrzesień 2026
- Linux Foundation i FINOS, AI and Open Source in Financial Services, wrzesień 2026
- Google, New insights from Google’s AI & Economy ATLAS, 15 września 2026
- Uniwersytet w Konstancji, Konstanzer KI-Studie 2026
- Everlaw, 2026 Legal AI Adoption & Impact Report
- Inero Software, test lekkich modeli na polisach, kwiecień 2025
- OWASP, Top 10 for LLM Applications 2025
- Cloud Security Alliance o Digital Omnibus i terminach AI Act
- Eurostat, Use of artificial intelligence in enterprises