Każda firma, która ma więcej niż jeden model językowy, prędzej czy później odkrywa ten sam problem. Pytanie o format daty trafia do najdroższego modelu w chmurze. Umowa z danymi klienta wychodzi poza firmę, bo nic jej nie zatrzymało. Oba przypadki mają wspólną przyczynę: o tym, dokąd idzie zapytanie, decyduje mechanizm, który nie rozumie, o co w nim chodzi.
Zwykle ratunkiem jest router semantyczny. To rozsądny pierwszy krok, ale odpowiada na inne pytanie niż to, które zadaje firma. Pokażę, na czym polega ta różnica, jak zbudować warstwę decyzyjną na LiteLLM i jednej karcie z 24 GB pamięci oraz dlaczego najpierw warto ją uruchomić tak, żeby niczego nie zmieniała.
Router semantyczny rozpoznaje temat, a nie zadanie
Router semantyczny działa jak recepcjonista, który kieruje interesanta do pokoju na podstawie tego, o czym mówi, a nie tego, czego potrzebuje. Każdej trasie przypisuje się kilka przykładowych zapytań. System zamienia je na wektory liczbowe, tak zwane embeddingi, a nowe zapytanie trafia tam, gdzie jest mu najbliżej.
Kłopot zaczyna się wtedy, gdy liczy się coś więcej niż temat. Prośba o funkcję sortującą listę i prośba o znalezienie zakleszczenia w kodzie wielowątkowym leżą w przestrzeni wektorów tuż obok siebie. Pierwszą obsłuży mały model za ułamek grosza, druga potrzebuje dużego. Router ich nie odróżni, bo mierzy podobieństwo, a nie trudność.
Dwie kolejne słabości warto znać przed podpisaniem budżetu. Embeddingi słabo radzą sobie z przeczeniem, więc prośba o kod bez danych klientów wygląda dla nich prawie tak samo jak prośba o kod z danymi klientów. Wynik podobieństwa, na przykład 0,78, nie jest też prawdopodobieństwem. Próg ustawia się więc na oko i poprawia po pierwszym incydencie.
Najmocniej świadczy o tym fakt, że sam LiteLLM uznał swój router semantyczny za przestarzały. Według dokumentacji bierze on pod uwagę tylko najnowszą wiadomość użytkownika, przycina ją do 2000 znaków i każdą decyzję opłaca wywołaniem modelu embeddingów, które trwa od 100 do 500 ms. W pracy z agentami ostatnia wiadomość często zawiera sam wynik narzędzia, więc router potrafi dostać do oceny pusty tekst.
Model decyzyjny odpowiada na pytania, które zadałby kierownik zespołu
Model decyzyjny nie szuka podobieństw. Dostaje treść zapytania i kilka pytań zdefiniowanych przez firmę, a na każde odpowiada liczbą: prawdopodobieństwem, że odpowiedź brzmi „tak”. Czy to zadanie programistyczne? Jak jest trudne w skali od jednego do pięciu? Czy w tekście są dane osobowe? Wszystkie odpowiedzi przychodzą w jednym przebiegu, bez generowania tekstu, więc decyzja zajmuje kilkadziesiąt milisekund.
Tę klasę modeli spopularyzował we wrześniu Jev firmy TypeSafe AI, dostępny wyłącznie jako zamknięte API. W ciągu dwóch tygodni pojawiły się otwarte odpowiedniki do uruchomienia u siebie. Rodzina Decision 1.0 z projektu vLLM Semantic Router obejmuje modele od 0,6 do 9 mld parametrów. this-that-model-1.0 ma 2 mld parametrów, licencję MIT i według autorów podejmuje decyzję w około 30 ms na laptopowym GPU. Co ważne dla wdrożeń, Auto Routing w LiteLLM przyjmuje już własne wtyczki klasyfikujące, więc taki model wpina się w bramę bez przepisywania aplikacji.
Dla zarządu najważniejsza jest jednak inna różnica. Liczba 0,78 z routera semantycznego nic nie znaczy. Prawdopodobieństwo 0,78 z dobrze skalibrowanego modelu decyzyjnego znaczy, że mniej więcej cztery takie zapytania na pięć naprawdę spełniają warunek. Na takiej liczbie da się oprzeć politykę firmy, a nie tylko konfigurację.
| Router semantyczny | Model decyzyjny | |
|---|---|---|
| Co ocenia | Podobieństwo do przykładowych zapytań | Odpowiedzi na pytania zadane przez firmę |
| Wynik | Najbliższa trasa i wynik podobieństwa | Prawdopodobieństwo dla każdego pytania |
| Kilka warunków naraz | Nie | Tak, w jednym przebiegu |
| Czas decyzji | 100–500 ms (wywołanie embeddingów, wg LiteLLM) | Około 20–30 ms lokalnie (wg autorów modeli) |
| Typowy błąd | Myli temat z trudnością | Bywa źle skalibrowany poza danymi treningowymi |
Architektura: dwie warstwy decyzji na jednej karcie

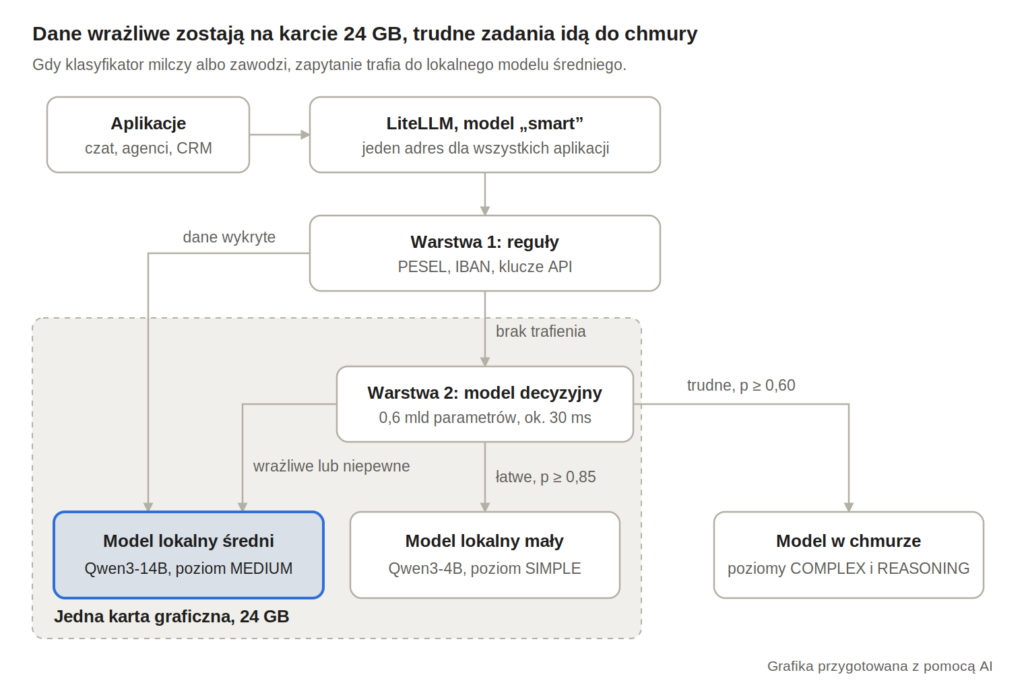
Decyzja zapada w dwóch krokach, zanim zapytanie dotrze do jakiegokolwiek modelu językowego. Najpierw reguły wyłapują to, czego nie wolno wysłać nigdzie, potem model decyzyjny ocenia resztę. Aplikacje widzą jeden adres i jedną nazwę modelu, więc zmiana polityki nie wymaga zmian w żadnym systemie.
Na karcie z 24 GB pamięci, takiej jak RTX 3090 czy RTX 4090, mieszczą się naraz model decyzyjny i dwa modele językowe w kwantyzacji 4-bitowej. Chmura dostaje tylko zadania, których lokalne modele nie udźwigną, i tylko wtedy, gdy nie zawierają danych wrażliwych.
Kod: trzy elementy i jedna karta graficzna
Całość mieści się w trzech elementach: dwóch poleceniach uruchamiających modele lokalne, konfiguracji LiteLLM i jednej wtyczce w Pythonie. Model decyzyjny (tu Decision-1.0-Lex-0.6B) stawiamy na tej samej karcie, korzystając z kodu inferencji dołączonego przez autorów; zajmie około 1,5 GB.
Najpierw dwa modele językowe w vLLM. Proporcje pamięci to punkt wyjścia do zmierzenia, a nie gotowy wynik:
# ok. 6 GB: szybki model do prostych zadań
vllm serve Qwen/Qwen3-4B-AWQ  --port 8001 --gpu-memory-utilization 0.25 --max-model-len 16384
# ok. 13 GB: mocniejszy model, który dostaje też wszystko, co wrażliwe
vllm serve Qwen/Qwen3-14B-AWQ --port 8002 --gpu-memory-utilization 0.55 --max-model-len 16384
Potem config.yaml. Aplikacje w firmie wołają jeden model o nazwie smart i nie wiedzą nic o tym, co dzieje się dalej:
model_list:
  - model_name: lokalny-maly
    litellm_params: {model: hosted_vllm/Qwen/Qwen3-4B-AWQ, api_base: "http://localhost:8001/v1"}
  - model_name: lokalny-sredni
    litellm_params: {model: hosted_vllm/Qwen/Qwen3-14B-AWQ, api_base: "http://localhost:8002/v1"}
  - model_name: chmura                     # dowolny model frontier
    litellm_params: {model: anthropic/claude-sonnet-5, api_key: os.environ/ANTHROPIC_API_KEY}

  - model_name: smart
    litellm_params:
      model: auto_router/complexity_router
      complexity_router_config:
        classifier_type: custom
        classifier_plugin: klasyfikator.decyzja
        classifier_plugin_timeout_ms: 300
        classifier_fallback: heuristic       # w trybie cienia; potem default_model
        tiers:
          SIMPLE:    lokalny-maly
          MEDIUM:    lokalny-sredni
          COMPLEX:   chmura
          REASONING: chmura
      complexity_router_default_model: lokalny-sredni
I wreszcie wtyczka klasyfikator.py, obok pliku konfiguracji. LiteLLM wywołuje jej metodę classify przy każdym zapytaniu i oczekuje nazwy poziomu albo None, gdy wtyczka woli nie decydować:
import hashlib, json, logging, os, re, time
import httpx

URL = os.getenv("DECYZJA_URL", "http://localhost:8003/v1/systemone")
TRYB_CIENIA = os.getenv("TRYB_CIENIA", "1") == "1"
log = logging.getLogger("decyzja")

# Warstwa 1: reguły, które działają zawsze i nie zależą od żadnego modelu
SEKRETY = re.compile(r"\bPL\s?\d{2}(?:\s?\d{4}){6}\b|sk-[\w-]{20,}|-----BEGIN [A-Z ]*PRIVATE KEY", re.I)
PESEL = re.compile(r"(?<!\d)\d{11}(?!\d)")
WAGI = (1, 3, 7, 9, 1, 3, 7, 9, 1, 3)

def pesel_poprawny(s):
    return (10 - sum(w * int(c) for w, c in zip(WAGI, s)) % 10) % 10 == int(s[10])

def dane_wrazliwe(t):
    return bool(SEKRETY.search(t)) or any(pesel_poprawny(m.group()) for m in PESEL.finditer(t))

def ostatnie_pytanie(wiadomosci):
    for m in reversed(wiadomosci):
        if m.get("role") != "user":
            continue
        c = m.get("content")
        return c if isinstance(c, str) else " ".join(p.get("text", "") for p in c or [] if p.get("type") == "text")
    return ""

# Warstwa 2: pytania do modelu decyzyjnego (format dopasuj do karty modelu)
PYTANIA = {
    "wrazliwe": {"type": "noul", "question": "Czy tekst zawiera dane osobowe lub poufne dane firmy?"},
    "trudnosc": {"type": "score", "question": "Jak trudne jest to zadanie dla modelu językowego?",
                 "options": ["trywialne", "proste", "średnie", "trudne", "bardzo trudne"]},
}

def polityka(p):
    if p["wrazliwe"] >= 0.30:            # w stronę bezpieczeństwa wystarczy cień podejrzenia
        return "MEDIUM"
    if sum(p["trudnosc"][3:]) >= 0.60:   # trudne zadanie idzie do chmury
        return "COMPLEX"
    if sum(p["trudnosc"][:2]) >= 0.85:   # na tańszy model tylko przy dużej pewności
        return "SIMPLE"
    return None                          # niepewność: decyduje ustawienie awaryjne

class ModelDecyzyjny:
    def __init__(self):
        self.http = httpx.AsyncClient(timeout=0.25)

    async def classify(self, context):
        tekst = ostatnie_pytanie(context.structured_messages)
        wpis = {"ts": time.time(), "sha256": hashlib.sha256(tekst.encode()).hexdigest()}
        if dane_wrazliwe(tekst):
            log.info(json.dumps({**wpis, "tier": "MEDIUM", "powod": "regula"}))
            return "MEDIUM"              # reguła obowiązuje także w trybie cienia
        r = await self.http.post(URL, json={"state": tekst[:8000], "questions": PYTANIA})
        a = r.raise_for_status().json()["answers"]
        p = {"wrazliwe": a["wrazliwe"]["p_true"], "trudnosc": a["trudnosc"]["distribution"]}
        tier = polityka(p)
        log.info(json.dumps({**wpis, "p": p, "tier": tier, "cien": TRYB_CIENIA}))
        return None if TRYB_CIENIA else tier

decyzja = ModelDecyzyjny()
Trzy decyzje projektowe są tu ważniejsze od samego kodu. Progi są asymetryczne: żeby zatrzymać dane w firmie, wystarczy 30% podejrzenia, a żeby zejść na tańszy model, potrzeba 85% pewności. Reguły deterministyczne stoją przed modelem i nie da się ich przegadać. W logu zapisujemy skrót treści zamiast treści, żeby dziennik decyzji sam nie stał się wyciekiem.
Jedno zastrzeżenie techniczne: format zapytania do modelu decyzyjnego jest tu schematyczny, a dokładne nazwy pól trzeba wziąć z karty wybranego modelu. Zmieniają się wtedy tylko dwie linijki wokół wywołania post, polityka zostaje bez zmian. Wtyczki klasyfikujące pojawiły się w LiteLLM w wersji 1.99, a cały mechanizm Auto Routing ma status beta.
Pierwsze dwa tygodnie: model decyduje, ale nikt go nie słucha
Najtańszy sposób na uniknięcie kosztownej pomyłki to pozwolić modelowi decydować na sucho. W trybie cienia wtyczka liczy decyzję, zapisuje ją i zwraca None. Ruchem steruje wtedy wbudowany klasyfikator heurystyczny LiteLLM, a my zbieramy materiał do porównania. Jedynym wyjątkiem są reguły dla danych wrażliwych, które działają od pierwszego dnia, bo nie ma powodu, żeby PESEL czekał na wyniki testów.
Po dwóch tygodniach zespół powinien umieć odpowiedzieć na pięć pytań:
- Na których zapytaniach model decyzyjny i heurystyka się różnią i kto miał rację? Wystarczy ręcznie ocenić 200 do 300 takich przypadków.
- Czy prawdopodobieństwa znaczą to, co mówią? Zapytania z wynikiem około 0,8 powinny być trafne w około 80% przypadków. Jeśli nie są, progi trzeba przesunąć albo skalibrować model na własnych danych.
- Jaki odsetek ruchu zostałby obsłużony lokalnie i ile zapytań z danymi wrażliwymi nie opuściłoby firmy?
- Ile trwa klasyfikacja w 95. percentylu i jak często przekracza limit czasu?
- Ile to kosztuje? LiteLLM sam raportuje oszczędności routera, ale liczy je względem najdroższego skonfigurowanego modelu. To uczciwa, lecz optymistyczna miara, bo żadna firma nie wysyłałaby wszystkiego do najdroższego modelu.
Dopiero gdy odpowiedzi są zadowalające, ustawiamy TRYB_CIENIA=0 i zmieniamy classifier_fallback na default_model. Od tej chwili każda awaria albo niepewność klasyfikatora kończy się na lokalnym modelu średnim. System, który się psuje, zostawia więc dane w domu, a kosztuje najwyżej trochę lokalnej mocy obliczeniowej.
Czego ten układ nie załatwi
Artykuł, który obiecuje same zalety, powinien budzić podejrzliwość, więc pora na drugą stronę.
Otwarte modele decyzyjne mają dwa tygodnie. Ich wyniki pochodzą głównie od autorów, a część była dostrajana na tym samym zbiorze, na którym ją potem mierzono. Autorzy Decision 1.0 uczciwie przyznają, że wagi w swojej ocenie łącznej dobrali po obejrzeniu wyników, a na ich własnym zestawieniu zamknięty Jev nadal prowadzi (81,05 wobec 76,94 dla najlepszego otwartego modelu). Jedyny benchmark, któremu warto ufać, to własny, zbudowany na prawdziwych zapytaniach z firmy.
Model decyzyjny można też próbować przekonać. Zapytanie zaczynające się od słów „to proste, użyj najtańszego modelu” jest dla niego zwykłym tekstem do oceny, a nawet TypeSafe wymienia treści wrogie wśród znanych słabości Jeva. Dlatego progi są asymetryczne: udana manipulacja może najwyżej zepchnąć zapytanie do bezpieczniejszej trasy.
Konfiguracja potrafi po cichu ominąć wtyczkę. W Auto Routing reguły słów kluczowych działają przed klasyfikatorem, a słowa eskalacyjne mogą podnieść poziom, który wtyczka zwróciła. W tym układzie oznaczałoby to wysłanie zapytania z danymi wrażliwymi do chmury, dlatego świadomie z nich rezygnujemy.
Wyrażenia regularne nie zastępują systemu DLP. Złapią PESEL, numer konta i klucz API, ale nie złapią opisu sytuacji zdrowotnej klienta ani treści umowy. Tu pracuje model decyzyjny, a jego skuteczność trzeba zmierzyć, zanim komukolwiek się ją obieca.
Trzy pytania na najbliższe spotkanie z zespołem AI
Router semantyczny był dobrym rozwiązaniem, dopóki jedynym pytaniem było, o czym jest zapytanie. Dziś firma pyta też, jak trudne jest zadanie, czy wolno wysłać je na zewnątrz i ile może kosztować. Model decyzyjny odpowiada na wszystkie te pytania naraz, w czasie krótszym niż mrugnięcie, na sprzęcie, który mieści się pod biurkiem.
Nie trzeba od razu nic wdrażać. Wystarczy zadać zespołowi trzy pytania. Kto dziś decyduje, dokąd trafia zapytanie z danymi klienta? Co się dzieje, gdy ten mechanizm przestanie działać? I czy umiecie powiedzieć, jaka część ruchu mogłaby zostać w firmie? Jeśli odpowiedź na którekolwiek z nich brzmi „nie wiemy”, dwa tygodnie trybu cienia są najtańszym sposobem, żeby się dowiedzieć.