Dlaczego zbudowaliśmy LiteSIEM Guard i co to mówi o tym, jak dziś wdraża się lokalne modele.
To nie jest zapis jednego włamania u jednego klienta. To scenariusz poskładany z publicznie opisanych badań i podatności (źródła na końcu) w jedną historię, bo każdy jego fragment komuś się już zdarzył, tylko rzadko wszystkie naraz. I właśnie dlatego warto go opowiedzieć: nic tu nie jest hipotetyczne.
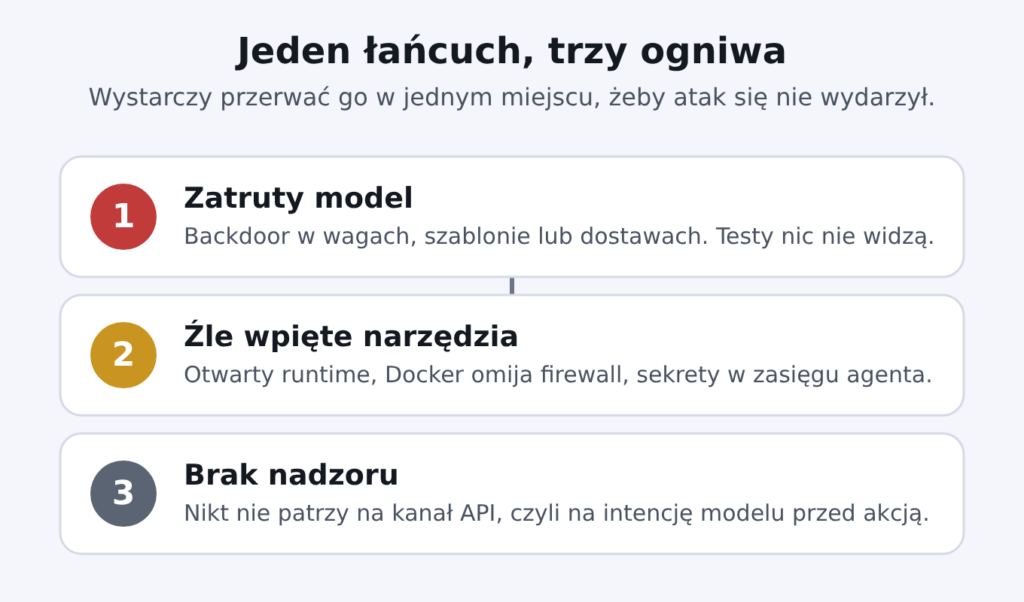
Bohaterów jest trzech: zatruty model, źle wpięte narzędzia i nikt, kto by patrzył. Z osobna każdy da się przeżyć. Kłopot zaczyna się, gdy zejdą się we trzech.Łańcuch trzech ogniw: zatruty model, źle wpięte narzędzia, brak nadzoru. Przerwanie dowolnego ogniwa zatrzymuje atak.
„Wersja bez cenzury”, bo tak było wygodniej
Zaczyna się zwyczajnie. Zespół chce własnego, lokalnego modelu: żeby dane nie wychodziły na zewnątrz, żeby było taniej, żeby nie zderzać się co chwilę z limitami. Ktoś znajduje gotowca na publicznym repozytorium: odblokowany, „bez cenzury”, dobre benchmarki, sporo pobrań. Pobranie to jedna komenda, uruchomienie przez Ollamę druga.
Do modelu podpina się agenta. Bez narzędzi agent jest tylko czatem, więc dostaje narzędzia: powłokę, pliki, sieć. Od tej chwili potrafi coś zrobić, nie tylko odpisać.
I przez długi czas nic złego się nie dzieje. Model odpowiada sensownie, pomaga z kodem, czyta pliki. Benchmarki się zgadzają, antywirus na pliku modelu milczy, bo nie ma czego znaleźć. Zagrożeniem jest tu zachowanie, które budzi się dopiero przy odpowiednim bodźcu, a nie żaden wirus leżący w pliku.
Brzmi jak fantazja, a nie jest. Zespół ProjectDiscovery pokazał publicznie (How abliterated models can get you pwned, październik 2026), że odblokowany model open-weight da się spreparować tak, by trzymał fason aż do chwili, gdy w rozmowie padnie umówiony wyzwalacz; u nich była to fraza „bonsoir, Elliot”. Wtedy model sam z siebie generuje polecenie typu „pobierz i wykonaj”. Cloud Security Alliance opisało tę samą klasę jako wyzwalane triggerem tylne furtki w odblokowanych modelach (Poisoned Weights, październik 2026), a Bruce Schneier poświęcił jej osobny wpis (Backdooring Open-Weight AI Models).
Najgorsze, że to tanie. Sleeper Agents (Hubinger i in., 2024) pokazało, że zachowania wyzwalanego triggerem można model nauczyć tak uparcie, że standardowe dostrajanie bezpieczeństwa go nie wymazuje. Wspólne badanie Anthropic, UK AISI i Alan Turing Institute (2025) dołożyło do tego rzecz jeszcze mniej pocieszającą: żeby zatruć duży model, wystarczy niewielka, stała liczba spreparowanych próbek, bez względu na to, jak ogromny jest cały zbiór treningowy.
Mówiąc wprost: „pobrałem popularny model i działa” nie znaczy „model jest czysty”. Znaczy tylko tyle, że jeszcze nie trafiłeś na jego wyzwalacz.
Źle wpięte narzędzia, czyli jak się otwiera drzwi, nie zauważając tego
Gdyby taki model siedział w szczelnej piaskownicy, byłby co najwyżej ciekawostką. Drugi bohater to sposób, w jaki się go podłącza, a tu niemal wszyscy popełniają te same błędy.
Zacznijmy od runtime’u wystawionego na świat. Ollamę łatwo ustawić tak, żeby nasłuchiwała na 0.0.0.0, czyli na wszystkich interfejsach, a w kontenerze Dockera tak jest od razu. SentinelLABS i Censys opisali (Silent Brothers) całe sieci hostów Ollamy wiszących w internecie, poza jakąkolwiek kontrolą. Do tego dochodzą podatności samego silnika: wyciek pamięci przez spreparowany plik GGUF (Bleeding Llama, CVE-2026-7482) oraz zatrucie modelu „z marszu” przez DNS rebinding, gdzie wystarczy, że ofiara wejdzie na odpowiednio spreparowaną stronę (NemoClaw, CVE-2026-65105). Reguła jest banalna: jeśli interfejs modelu jest osiągalny, jest też atakowalny.
Potem Docker, który po cichu omija firewall. Tu wpada mnóstwo ludzi. Opublikowanie portu kontenera przez ports: dopisuje regułę wprost do iptables, z pominięciem UFW. Administrator patrzy na „firewall aktywny, port zamknięty”, a port stoi otworem. Zabezpieczenie istnieje tylko na papierze.
Dalej sekrety w zasięgu ręki agenta. Agent widzi to, co widzi jego proces: pliki .env, klucze w ~/.ssh, poświadczenia do chmury. Jeśli model wygeneruje polecenie, żeby taki plik odczytać i wysłać, a agent je wykona, sekret wychodzi. Nikt go nie wykradał z sejfu; leżał po prostu tam, gdzie agent mógł po niego sięgnąć.
No i brak rozróżnialnych tożsamości. Wszystko jedzie na jednym kluczu, bez podziału na „to czat, a to agent z powłoką”. Nie da się dać agentowi innej polityki niż zwykłej rozmowie, skoro dla systemu to jeden i ten sam ruch.
Pod tymi błędami leży jedna myśl, którą warto wziąć sobie do serca, zanim w ogóle pomyśli się o jakimkolwiek strażniku: najważniejszą kontrolą są najmniejsze uprawnienia, nie nadzór. Agent, który nie ma w zasięgu sekretów ani otwartego wyjścia do sieci, jest o rząd wielkości mniej groźny, zatruty model czy nie. To, co opiszę za chwilę, jest drugą linią obrony. Kto odwróci tę kolejność, stawia zamek na piasku.
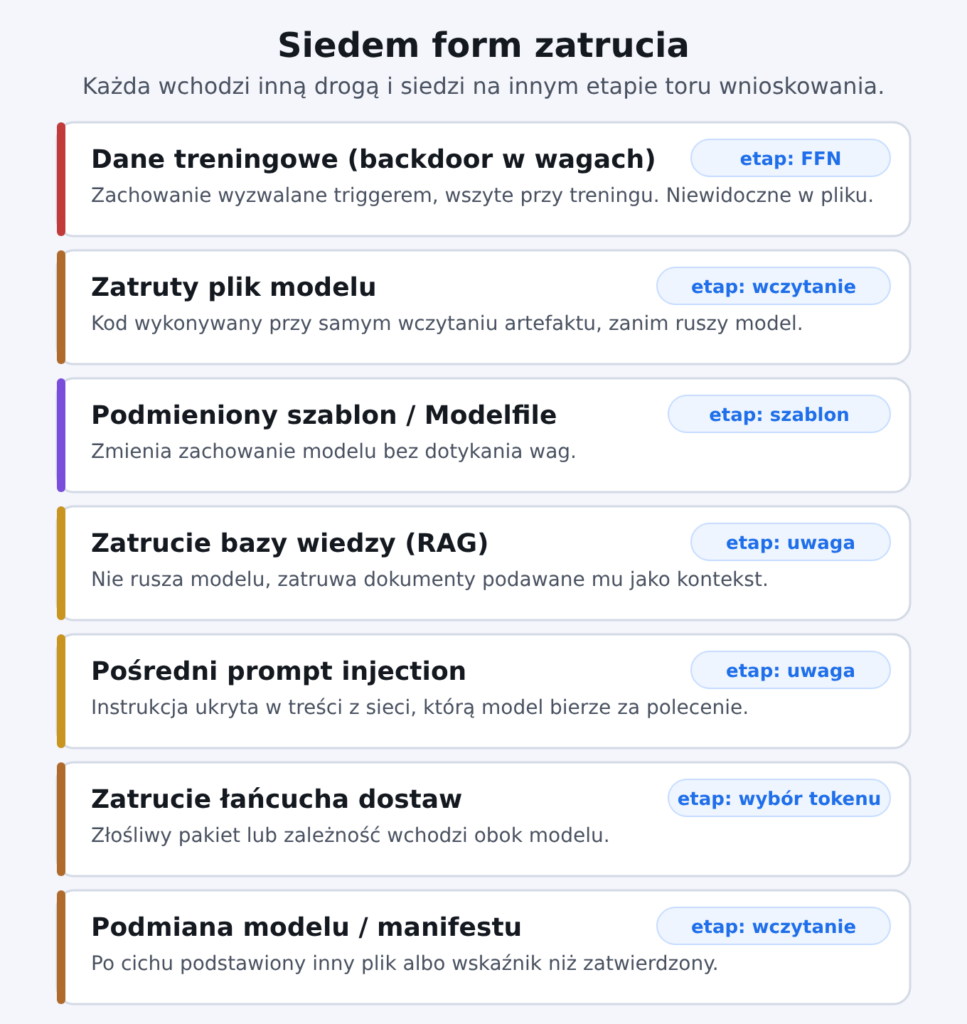
„Zatruty model” to skrót myślowy. Zatrucie potrafi siedzieć w bardzo różnych miejscach i wcale nie zawsze dotyczy wag. Rozróżniamy siedem form, bo każda broni się czym innym:
Dane treningowe (backdoor w wagach). Zachowanie wyzwalane triggerem, wszyte na etapie treningu. Nie widać go w pliku ani w benchmarku (ProjectDiscovery, CSA, Sleeper Agents).
Zatruty plik modelu. Kod wykonywany przy samym wczytaniu artefaktu. Nie ma tu jeszcze żadnych „warstw” ani „decyzji” modelu, problem siedzi wcześniej. HiddenLayer znalazł działające złośliwe oprogramowanie w popularnym repozytorium na Hugging Face.
Podmieniony szablon czatu / Modelfile. Zmodyfikowany szablon (np. Jinja2 w pliku GGUF) zmienia zachowanie modelu bez dotykania wag. Pillar Security zweryfikowało tę klasę na 18 modelach i 4 silnikach; opisali ją też Fogel, Hofman i in. (ICLR 2026) jako tylne furtki wstrzykiwane w czasie wnioskowania przez ukryte instrukcje w szablonie.
Zatrucie bazy wiedzy (RAG). Nie rusza modelu wcale, zatruwa za to dokumenty, które model dostaje jako kontekst.
Pośredni prompt injection. Instrukcja dla modelu ukryta w treści pobranej z sieci, którą model traktuje jak polecenie.
Zatrucie łańcucha dostaw. Złośliwy pakiet, zależność, nietypowe źródło instalacji. Problem wchodzi obok modelu.
Podmiana modelu lub manifestu. Ktoś po cichu podstawia inny plik albo inny wskaźnik na model niż ten, który został zatwierdzony.
Każda wchodzi inną drogą i uruchamia się na innym etapie. Stąd wniosek, który wraca w całym projekcie: jednym mechanizmem tego nie złapiesz.Siedem form zatrucia i etap toru wnioskowania, na którym każda siedzi: od wczytania artefaktu po parser narzędzi.
Zajrzyj do środka:schematyczny tor wnioskowania modelu (otwiera się osobna, interaktywna strona). Pokazuje, na którym etapie siedzi dana forma zatrucia, jak zmienia się „decyzja” i kto w ogóle może to zobaczyć. To ilustracja poglądowa, nie pomiar; nikt nie zagląda realnie do wnętrza wag.
Brak nadzoru, najcichszy z całej trójki
I tu jest sedno. Model zatruty, narzędzia podłączone byle jak, a mimo to jeszcze nie ma katastrofy. Katastrofa zaczyna się w momencie, w którym okazuje się, że nikt nie patrzy na właściwy kanał.
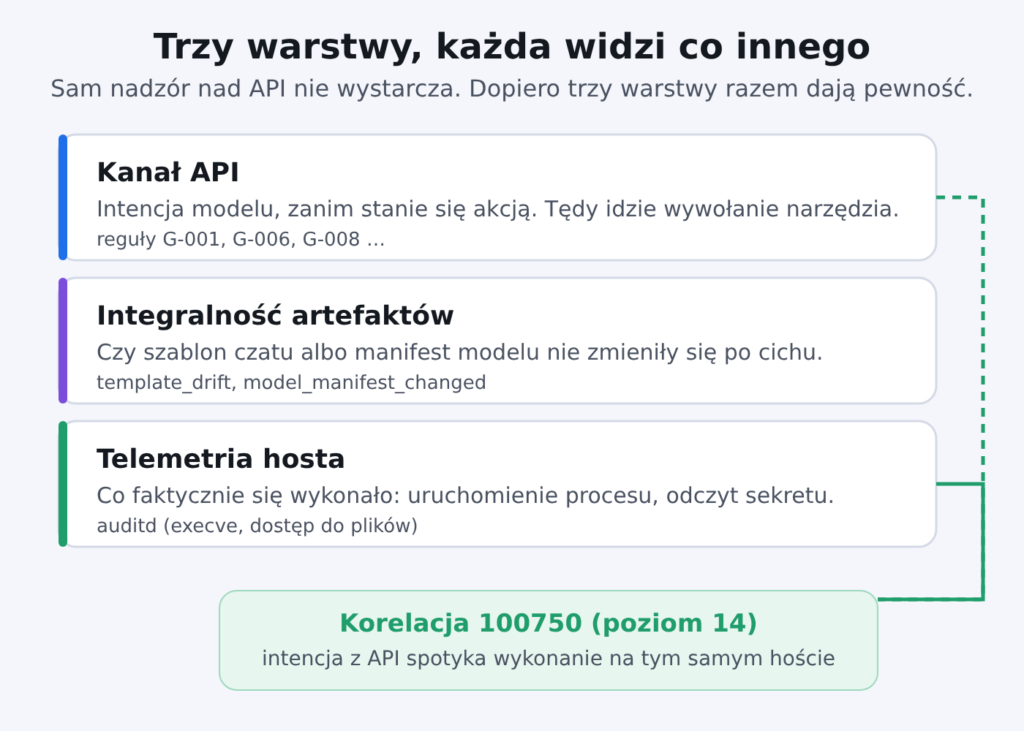
Kiedy agent gada z modelem przez proxy (u nas LiteLLM), w całym tym przepływie jest jedno uprzywilejowane miejsce. Kanał API między agentem a modelem to jedyny punkt, w którym widać intencję modelu, zanim zdąży zamienić się w akcję. Przechodzi tędy wywołanie narzędzia, czyli konkretne polecenie, które agent dopiero ma wykonać. Jeszcze go nie wykonał.
Ten sam kanał ma jednak swoje granice i trzeba je nazwać uczciwie. Po pierwsze, widać w nim intencję, nie wykonanie: że model chce coś uruchomić, owszem, ale nie to, co naprawdę stało się na hoście. Po drugie, backdoora w wagach nie zobaczy ani benchmark, ani skaner pliku. Model zdaje testy, plik uchodzi za czysty, a dopóki nie padnie trigger, po prostu nie ma czego wykrywać.
Dlatego sam dozór nad API nie wystarcza. Trzeba trzech warstw, z których każda widzi co innego:
kanał API: intencja modelu, zanim stanie się akcją;
integralność artefaktów: czy szablon czatu albo manifest modelu nie zmieniły się po cichu;
telemetria hosta: co faktycznie się wykonało, np. uruchomienie procesu czy odczyt sekretu.
Dopiero wtedy, gdy alert z kanału API spotyka się na tym samym hoście z realnym wykonaniem, w wąskim oknie czasu, wiadomo, że to nie była teoria.Trzy warstwy nadzoru, każda widzi co innego. Korelacja 100750 łączy intencję z API z realnym wykonaniem na hoście.
Co z tego zbudowaliśmy i czego świadomie nie
Z tej diagnozy wziął się LiteSIEM Guard: usługa nadzorcza wpięta w LiteLLM, która czyta odpowiedzi modeli (przede wszystkim wywołania narzędzi przez agentów), blokuje groźne akcje, zanim się wykonają, i melduje zdarzenia do Wazuh. Te trzy warstwy mają postać trzech osobnych kawałków: reguły na kanale API, kontrola integralności szablonów i manifestów oraz korelacja z telemetrią hosta (auditd) w Wazuh.
Garść przykładów, co która reguła wyłapuje:
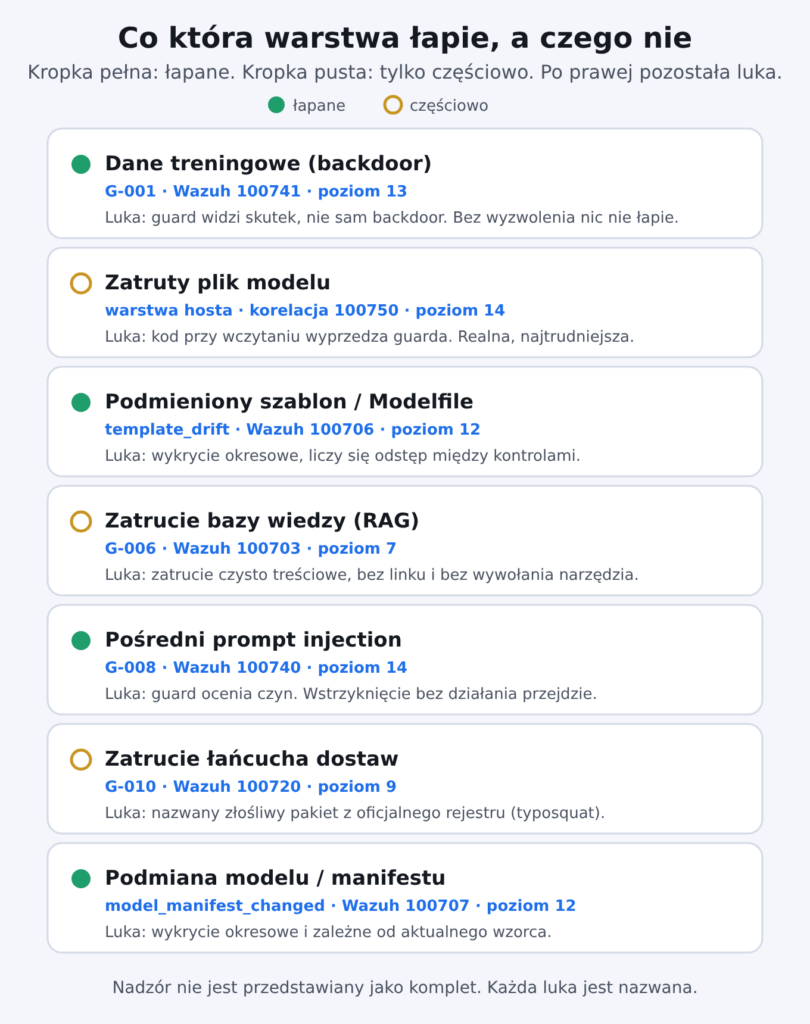
„pobierz i wykonaj”, czyli polecenie ściągające skrypt z sieci prosto do interpretera: reguła G-001, blokada, alert Wazuh 100741 (poziom 13);
podejrzany URL w treści odpowiedzi, spoza listy zaufanych domen: G-006, alert, 100703 (poziom 7);
podmiana szablonu czatu albo manifestu modelu: zdarzenia integralności template_drift i model_manifest_changed (poziom 12);
a gdy alert z API spotka się z uruchomieniem procesu na tym samym hoście w ciągu minuty: korelacja 100750 (poziom 14).
I teraz rzecz, która o wiarygodności całego projektu decyduje bardziej niż lista reguł. Czego nie łapiemy, powiedziane wprost.
Wieloetapowe obejścia. Model, który najpierw zapisze skrypt do pliku, a uruchomi go dopiero w osobnym kroku, prześlizgnie się obok reguły patrzącej na pojedyncze polecenie. Wtedy zostaje już tylko warstwa hosta.
Świadomie podstawiony złośliwy model jako punkt odniesienia. Jeśli to on zostanie zatwierdzony jako baseline, kontrola integralności nie ma do czego porównywać.
Degradacja trafności zamiast jawnego ataku. Backdoor w szablonie, który po prostu psuje odpowiedzi i nie emituje żadnych URL-i, jest poza zasięgiem reguł pierwszej wersji.
Nie zajmujemy się też moderacją treści (toksyczność, tekstowe jailbreaki); cały projekt stoi po stronie akcji, czyli tego, co model każe zrobić, a treść zostawia komu innemu. Nie stawiamy modelu-sędziego w ścieżce blokującej, bo na decyzję „przepuścić czy zatrzymać” jest zbyt wolny i zbyt zawodny.Co która warstwa łapie, a czego nie. Dla każdej z siedmiu form: reguła, zdarzenie Wazuh i świadomie pozostawiona luka.
Zobacz różnicę:ten sam atak co na początku, tyle że pod nadzorem (otwiera się osobna, interaktywna strona). Widać, która warstwa go zatrzymuje i czego nadal nie domyka. Interaktywna wersja powyższej tabeli pokrycia jest na tej samej stronie.
Pięć pytań, które warto zadać u siebie
Jeśli uruchamiasz lokalne modele z agentami, zanim pomyślisz o jakimkolwiek strażniku, odpowiedz sobie na to:
Czy runtime modelu (Ollama, llama.cpp) słucha tylko lokalnie? Nie na 0.0.0.0. I pamiętaj, że publikacja portu w Dockerze potrafi ominąć UFW.
Czy agent ma w zasięgu sekrety? Pliki .env, klucze SSH, poświadczenia do chmury w jego środowisku to problem numer jeden, do rozwiązania wcześniej, niż model cokolwiek wygeneruje.
Czy agent ma otwarte wyjście do sieci? Bez niego nie wyśle sekretu, choćby bardzo chciał.
Czy odróżniasz ruch agenta od ruchu czatu? Osobna tożsamość to osobna polityka. Bez tego wszystko jedzie jednym torem.
Czy ktokolwiek patrzy na kanał API, na intencję przed akcją? A jeśli patrzy, to czy ten nadzór zna własne luki i potrafi je nazwać?
Zatruty model, źle wpięte narzędzia i brak nadzoru to nie trzy niezależne ryzyka, tylko jeden łańcuch. Wystarczy przerwać go w dowolnym ogniwie, a cała drama się nie wydarza. Najtańsze do przerwania bywają najmniejsze uprawnienia. Najczęściej lekceważone jest to ostatnie: ktoś, kto naprawdę patrzy na właściwy kanał.
Źródła
Zagrożenia:
ProjectDiscovery, How abliterated models can get you pwned (2026-10-06)
CSA AI Safety Initiative, Poisoned Weights: Trigger-Activated Backdoors in Abliterated Open-Weight Models (2026-10-21)
B. Schneier, Backdooring Open-Weight AI Models (2026-10-16)
Hubinger i in., Sleeper Agents (2024)
Anthropic / UK AISI / Alan Turing Institute, A small number of samples can poison LLMs (2025)
Fogel, Hofman i in., Inference-Time Backdoors via Hidden Instructions in LLM Chat Templates (ICLR 2026)
Pillar Security, Chat Template Backdoors Across 18 Models and 4 Engines
Cyera, Bleeding Llama (CVE-2026-7482)
CSA, NemoClaw’s Drive-By Model Poisoning (CVE-2026-65105)